Từ File Excel Bán Hàng Đến Hệ Thống Production: Hành Trình Xây Dựng Bộ Não Dữ Liệu Cho Marketing
Case study minh hoạ cách biến hàng nghìn dòng giao dịch thô thành hệ thống dự đoán khách hàng rời bỏ, tính giá trị vòng đời, và ra quyết định marketing — kể lại từng bước, kèm công thức, biểu đồ và code.
- Vấn đề: khi marketing chạy bằng cảm tính
- RFM — ngôn ngữ chung giữa dữ liệu và marketing
- Phân khúc khách hàng với K-Means
- Dự đoán khách hàng rời bỏ với XGBoost
- Dự đoán giá trị vòng đời khách hàng (CLV)
- Gộp lại: ma trận ra quyết định
- Từ script sang sản phẩm: giao diện & quy chuẩn dữ liệu
- Kiến trúc khi triển khai thật
- Thử với dữ liệu CRM thật
- Những gì rút ra được
Đầu năm nay, nếu bạn hỏi một người mới học Machine Learning "làm sao để biết khách hàng nào sắp rời bỏ mình", câu trả lời thường là một cái nhún vai. Sáu tháng sau, câu trả lời có thể là một con số chính xác đến 88.5% — và đây là câu chuyện về quãng đường ở giữa hai thời điểm đó.
Phần 1 — Vấn đề: khi marketing chạy bằng cảm tính
Hãy tưởng tượng bạn là chủ một cửa hàng online với 4.000 khách hàng. Mỗi tháng, đội marketing gửi cùng một email khuyến mãi cho tất cả mọi người — từ khách VIP mua hàng mỗi tuần đến người chỉ mua đúng một lần rồi biến mất. Ngân sách quảng cáo được chia đều, không phân biệt ai đáng để giữ chân, ai gần như chắc chắn sẽ rời bỏ dù có làm gì đi nữa.
Đây không phải là tình huống hiếm gặp — đó là cách phần lớn doanh nghiệp vừa và nhỏ vận hành marketing: dựa vào trực giác thay vì dữ liệu. Vấn đề không nằm ở việc thiếu dữ liệu — hầu hết cửa hàng nào cũng có sẵn lịch sử giao dịch nằm im trong database hoặc file Excel. Vấn đề nằm ở việc không ai biến dữ liệu thô đó thành hành động cụ thể.
Làm sao để từ một bảng giao dịch — chỉ gồm mã khách hàng, ngày mua, số tiền — xây dựng được một hệ thống có thể trả lời: ai sắp rời bỏ, ai đáng đầu tư, và nên làm gì với từng người?
Câu trả lời đòi hỏi đi qua ba giai đoạn: hiểu khách hàng (phân khúc họ là ai), dự đoán tương lai (họ sẽ rời bỏ hay ở lại, sẽ chi bao nhiêu), và biến dự đoán thành hành động (ai cần gọi điện ngay, ai chỉ cần một email tự động). Ba giai đoạn này tương ứng với ba mô hình sẽ được kể trong bài viết — không phải theo kiểu tài liệu kỹ thuật khô khan, mà theo đúng thứ tự một người thật sẽ trải qua khi tự tay xây dựng nó.
Phần 2 — RFM: ngôn ngữ chung giữa dữ liệu và marketing
Trước khi có thể "hiểu" khách hàng, máy tính cần một cách nào đó để mô tả họ bằng con số. Đây chính xác là vai trò của RFM — một trong những framework lâu đời nhất và vẫn còn hữu dụng nhất trong ngành marketing dữ liệu, ra đời từ những năm 1990 khi các công ty đặt hàng qua thư (mail-order) cần một cách rẻ tiền để biết nên gửi catalogue cho ai.
RFM viết tắt của ba chỉ số:
| Chỉ số | Ý nghĩa | Công thức |
|---|---|---|
| Recency | Khách mua gần đây không? | (hôm nay − ngày mua cuối).days |
| Frequency | Khách mua thường xuyên không? | đếm số lần mua |
| Monetary | Khách chi bao nhiêu tiền? | tổng(giá trị đơn hàng) |
Điều thú vị của RFM không nằm ở độ phức tạp toán học — nó cực kỳ đơn giản — mà nằm ở việc ba con số này, khi đặt cạnh nhau, kể được gần như toàn bộ câu chuyện về "sức khỏe" mối quan hệ giữa một khách hàng và doanh nghiệp. Một khách hàng có Recency thấp (mới mua), Frequency cao (mua thường xuyên), Monetary cao (chi nhiều) gần như chắc chắn là khách VIP. Ngược lại, Recency cao (lâu không quay lại) kết hợp Frequency thấp là dấu hiệu cảnh báo sớm của một khách hàng sắp biến mất vĩnh viễn.
RFM không phải là thuật toán học máy — nó là bước feature engineering: biến đổi dữ liệu giao dịch thô (mỗi dòng là một đơn hàng) thành dữ liệu cấp khách hàng (mỗi dòng là một người). Không có bước này, không mô hình nào phía sau có thể chạy được, vì tất cả đều cần "1 dòng = 1 đối tượng cần dự đoán".
Về mặt kỹ thuật, đây là đoạn code thực hiện phép biến đổi đó — trông đơn giản, nhưng lại là bước quan trọng nhất trong toàn bộ pipeline vì mọi sai sót ở đây sẽ lan truyền xuống mọi mô hình phía sau:
Python · pandasrfm = transactions.groupby('CustomerID').agg(
Recency=('OrderDate', lambda x: (today - x.max()).days),
Frequency=('OrderDate', 'count'),
Monetary=('OrderValue', 'sum')
)
Chỉ ba dòng code, nhưng đằng sau nó là một quyết định thiết kế quan trọng: mốc thời gian tham chiếu. Nếu tính Recency dựa trên "hôm nay" theo nghĩa đen (thời điểm chạy code), một mô hình huấn luyện hôm nay sẽ cho ra kết quả khác hoàn toàn nếu chạy lại vào tuần sau — ngay cả khi không có giao dịch mới nào. Đây là lý do các hệ thống RFM chuyên nghiệp luôn cố định mốc tham chiếu tại thời điểm snapshot dữ liệu, chứ không phải thời điểm chạy script.
Phần 3 — Phân khúc khách hàng với K-Means
Có RFM trong tay, câu hỏi tiếp theo là: làm sao nhóm 4.000 khách hàng này thành các "bộ lạc" có hành vi tương tự nhau, để marketing không phải đối xử với tất cả như nhau? Đây là lúc K-Means Clustering — một trong những thuật toán unsupervised learning phổ biến nhất — bước vào cuộc chơi.
Ý tưởng của K-Means đơn giản đến bất ngờ: nếu vẽ mỗi khách hàng thành một điểm trong không gian 3 chiều (trục Recency, Frequency, Monetary), những khách hàng có hành vi giống nhau sẽ tự nhiên "tụ" lại gần nhau thành từng đám. K-Means chỉ đơn giản là đi tìm những đám đó.
Về mặt toán học, K-Means tối thiểu hóa một đại lượng gọi là WCSS (Within-Cluster Sum of Squares) — tổng bình phương khoảng cách từ mỗi điểm đến tâm cụm của nó:
J = Σ(k=1..K) Σ(x∈Ck) ||x - μk||²
Thuật toán chạy theo một vòng lặp hai bước rất trực quan, giống như một trò chơi "kéo co" nhẹ nhàng giữa các điểm dữ liệu và tâm cụm:
- 1.Assignment: mỗi điểm dữ liệu "bầu chọn" tâm cụm gần nó nhất để gia nhập
- 2.Update: mỗi tâm cụm di chuyển đến vị trí trung bình của tất cả các điểm vừa bầu cho nó
- 3.Lặp lại hai bước trên cho đến khi không còn điểm nào đổi phe — lúc này thuật toán đã hội tụ
Một chi tiết kỹ thuật dễ bị bỏ qua nhưng ảnh hưởng rất lớn đến kết quả cuối cùng: trước khi đưa dữ liệu vào K-Means, ba trục Recency, Frequency, Monetary phải được chuẩn hóa (standardize) về cùng thang đo. Lý do là vì Monetary thường có giá trị hàng triệu trong khi Frequency chỉ dao động vài chục — nếu không chuẩn hóa, thuật toán sẽ gần như chỉ "nhìn thấy" Monetary và bỏ qua hai trục còn lại.
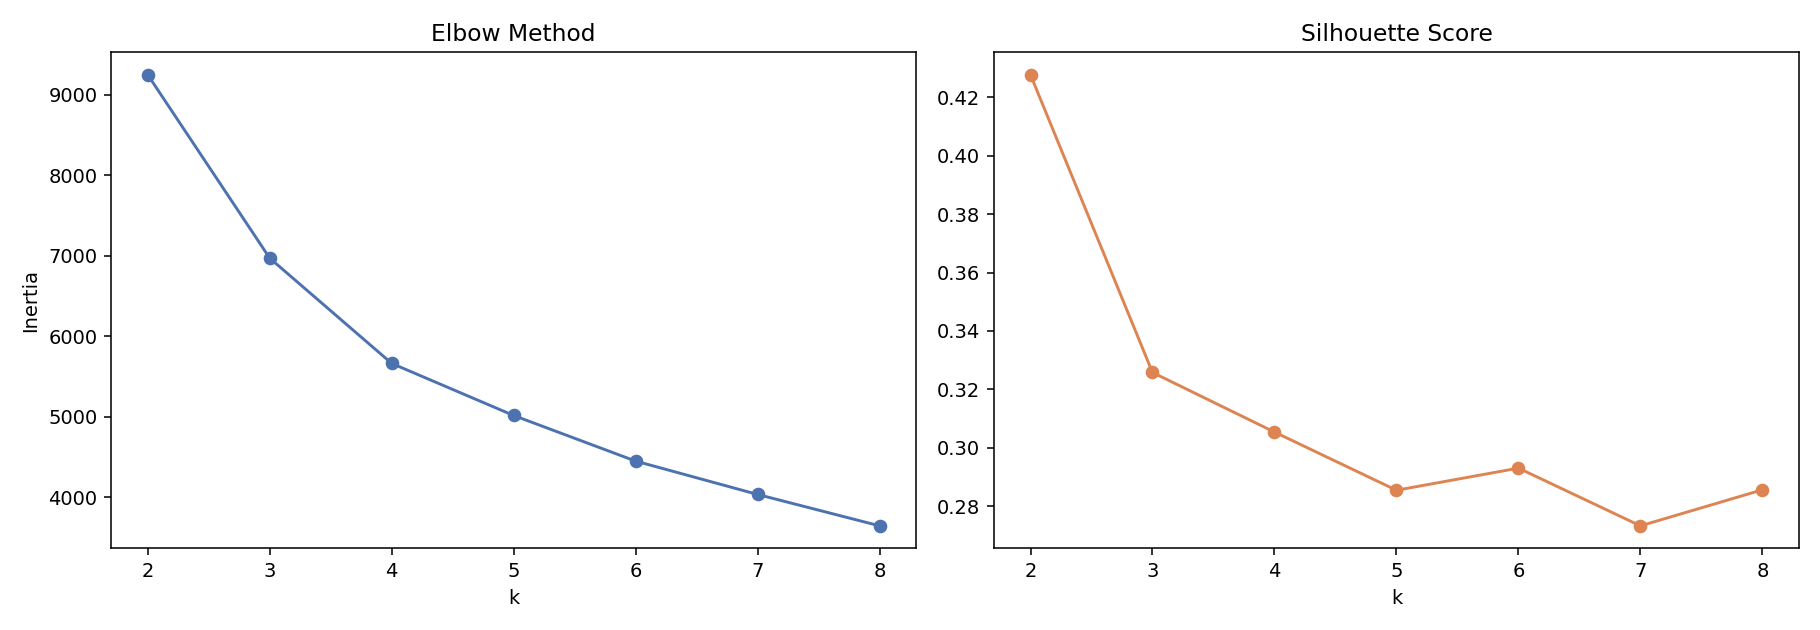
Một câu hỏi thực tế luôn nảy sinh: vậy nên chia bao nhiêu cụm? K-Means không tự trả lời được câu này — người dùng phải chỉ định trước số cụm K. Elbow Method giúp tìm câu trả lời bằng một mẹo trực quan: thử nhiều giá trị K khác nhau, vẽ đồ thị WCSS theo K, và tìm điểm mà đường cong "gãy khúc" giống hình khuỷu tay — đó là điểm mà việc thêm cụm không còn mang lại lợi ích đáng kể nữa.
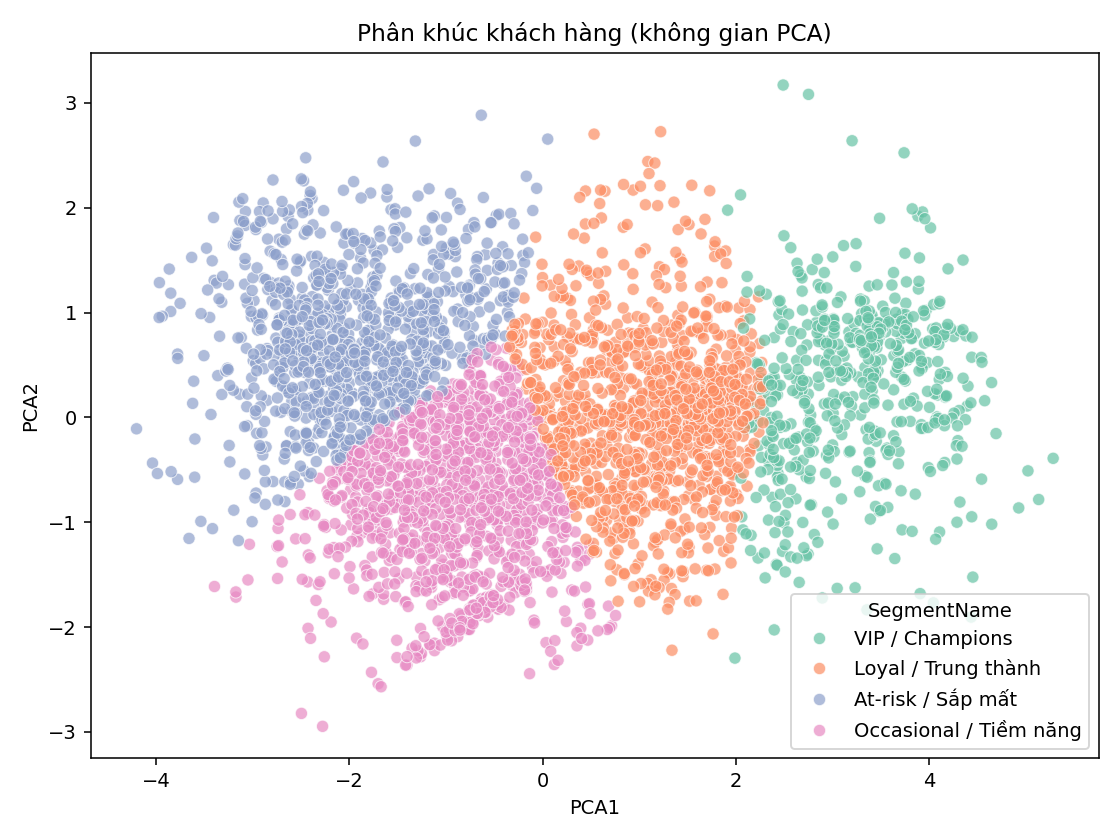
Kết quả thực nghiệm cho ra 4 cụm tách biệt khá rõ ràng. Nhưng một biểu đồ đẹp không tự động có nghĩa là mô hình đúng — bước kiểm chứng quan trọng nhất là nhìn vào đặc điểm trung bình của từng cụm và tự hỏi: "điều này có hợp lý về mặt kinh doanh không?"
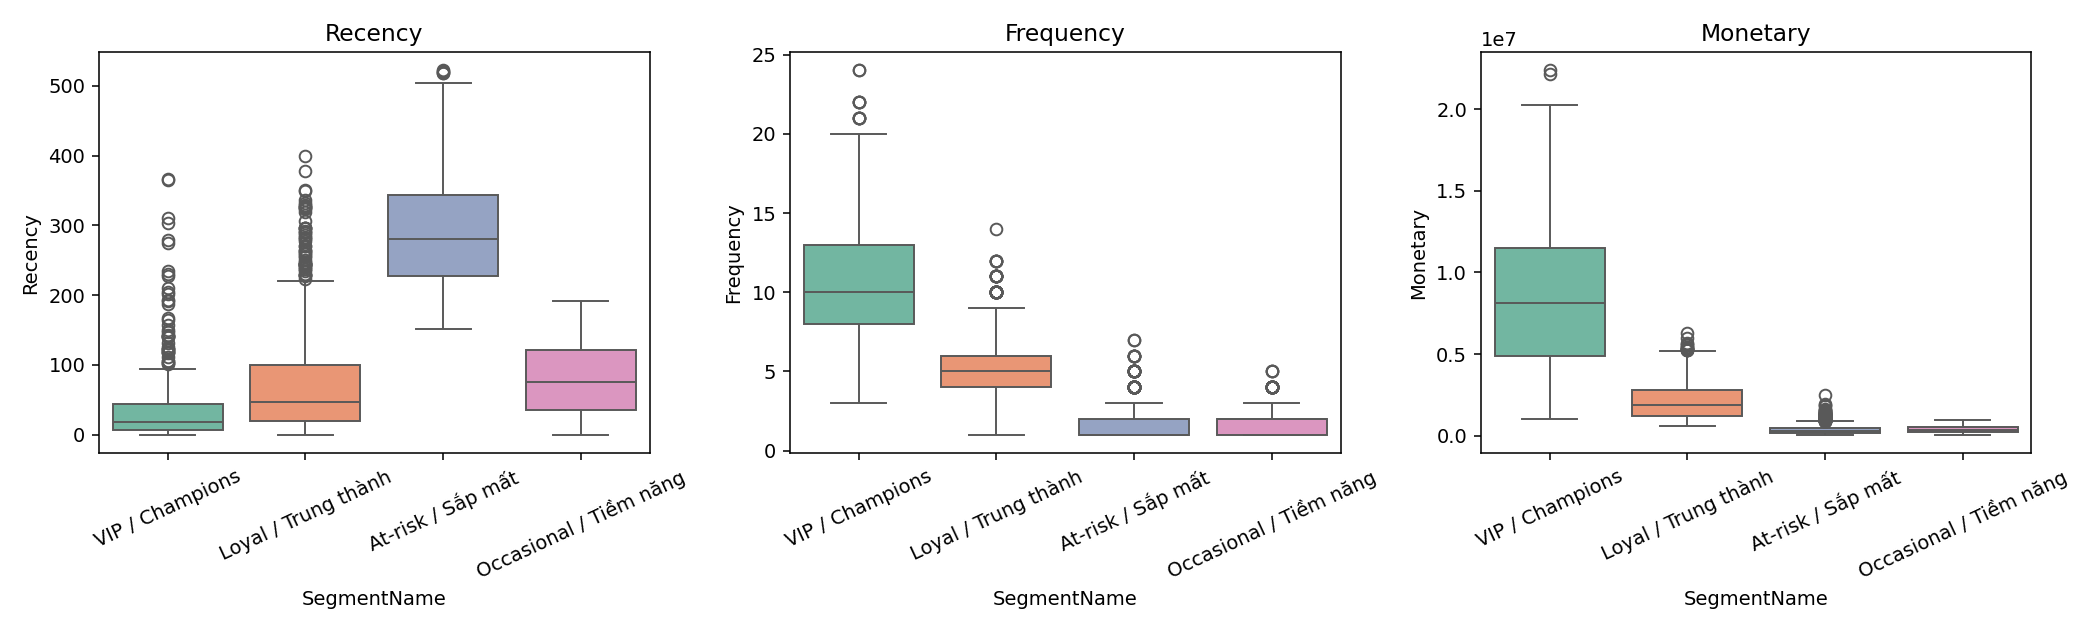
Nhìn vào biểu đồ trên, câu chuyện kể ra rất rõ ràng: có một nhóm khách hàng với Recency thấp, Frequency và Monetary cao vượt trội — đây chính là nhóm "VIP/Champions" đáng được chăm sóc đặc biệt. Ở phía đối lập là nhóm có Recency cao bất thường — dấu hiệu của những khách hàng đã "biến mất" khỏi hệ thống từ lâu.
Một mô hình phân khúc tốt không phải là mô hình có Silhouette Score cao nhất, mà là mô hình mà đội marketing nhìn vào và nói: "đúng rồi, tôi biết chính xác nên làm gì với từng nhóm này."
Phần 4 — Dự đoán khách hàng rời bỏ với XGBoost
Phân khúc khách hàng trả lời câu hỏi "họ là ai". Nhưng câu hỏi cấp bách hơn với bất kỳ đội marketing nào là: "ai trong số họ sắp bỏ đi?" — và quan trọng hơn, "bỏ đi trước khi mình kịp làm gì đó để giữ họ lại?"
Đây là bài toán churn prediction — một trong những ứng dụng Machine Learning sinh lời rõ ràng nhất trong kinh doanh, vì một nguyên lý kinh tế đơn giản: giữ chân một khách hàng cũ luôn rẻ hơn tìm một khách hàng mới, đôi khi rẻ hơn đến 5-7 lần. Nếu biết trước ai sắp rời bỏ, doanh nghiệp có cơ hội can thiệp — một cuộc gọi, một ưu đãi cá nhân hóa — trước khi quá muộn.
Để giải bài toán này, mình chọn XGBoost — viết tắt của Extreme Gradient Boosting, hiện là một trong những thuật toán được dùng nhiều nhất cho dữ liệu dạng bảng (tabular data) trong công nghiệp, từ các cuộc thi Kaggle đến hệ thống production của hàng nghìn công ty.
Cơ chế: học từ sai lầm của chính mình
XGBoost thuộc họ thuật toán gradient boosting — một ý tưởng nghe có vẻ phản trực giác lúc đầu: thay vì xây một mô hình lớn và mạnh ngay từ đầu, nó xây hàng trăm cây quyết định nhỏ và yếu, mỗi cây sau chuyên tâm sửa những lỗi mà các cây trước đó chưa sửa được.
ŷᵢ = Σ(t=1..T) fₜ(xᵢ)
Hãy tưởng tượng một lớp học với 300 gia sư, mỗi gia sư chỉ dạy 15 phút. Gia sư đầu tiên cố gắng giải thích toàn bộ bài học nhưng chắc chắn còn nhiều chỗ học sinh chưa hiểu. Gia sư thứ hai không dạy lại từ đầu — họ chỉ tập trung vào đúng những phần học sinh còn yếu sau buổi của gia sư đầu. Cứ thế tiếp diễn qua 300 gia sư, kiến thức tổng hợp cuối cùng trở nên rất vững chắc, dù từng "mảnh" kiến thức riêng lẻ rất nhỏ.
Về mặt toán học, "sai lầm cần sửa" được đo bằng một hàm mục tiêu kết hợp giữa độ chính xác và độ phức tạp của mô hình:
Obj = Σᵢ L(yᵢ, ŷᵢ) + Σₜ Ω(fₜ)
Vế đầu tiên, L(yᵢ, ŷᵢ), là hàm mất mát (loss function) — với bài toán churn (nhị phân: rời bỏ hoặc không), XGBoost dùng Log Loss:
L = -[y·log(p) + (1-y)·log(1-p)]
Vế thứ hai, Ω(fₜ), là số hạng phạt (regularization) — nó ngăn từng cây quyết định trở nên quá phức tạp, giống như việc nhắc mỗi gia sư "đừng cố nhồi nhét quá nhiều trong 15 phút của mình", giúp tránh hiện tượng overfitting (mô hình học thuộc lòng dữ liệu huấn luyện nhưng dự đoán tệ trên dữ liệu mới).
Thay vì chỉ dùng đạo hàm bậc 1 (gradient) như Gradient Boosting cổ điển, XGBoost sử dụng cả đạo hàm bậc 2 (Hessian) thông qua khai triển Taylor để tìm cấu trúc cây tối ưu nhanh và chính xác hơn — đây là lý do nó thường thắng các cuộc thi Machine Learning trên dữ liệu dạng bảng.
Cái bẫy nguy hiểm nhất: rò rỉ dữ liệu tương lai
Đây là phần mà hầu hết người mới học Machine Learning — và không ít người có kinh nghiệm — mắc phải sai lầm. Khi dự đoán "khách hàng có rời bỏ trong 6 tháng tới không", dữ liệu phải được chia theo mốc thời gian, tuyệt đối không được chia ngẫu nhiên (random split) như các bài toán thông thường.
PythonCUTOFF_DATE = '2025-07-01' hist = transactions[OrderDate < CUTOFF_DATE] # dùng để TÍNH feature future = transactions[OrderDate >= CUTOFF_DATE] # dùng để biết ĐÁP ÁN thật
Nếu bỏ qua nguyên tắc này, mô hình sẽ vô tình "nhìn thấy" thông tin từ tương lai trong lúc huấn luyện — kết quả đánh giá trên tập test sẽ đẹp một cách giả tạo (đôi khi ROC-AUC lên đến 0.99), nhưng khi đưa vào thực tế, mô hình sẽ thất bại thảm hại vì trong đời thực, không ai biết trước tương lai để "gian lận" như vậy.
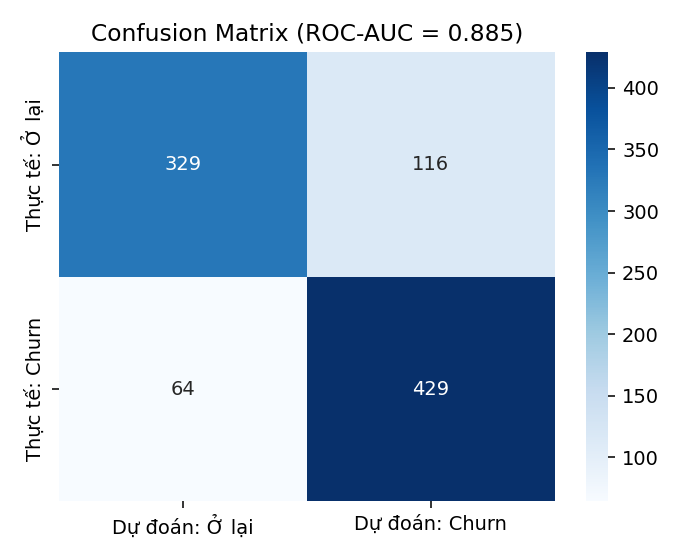
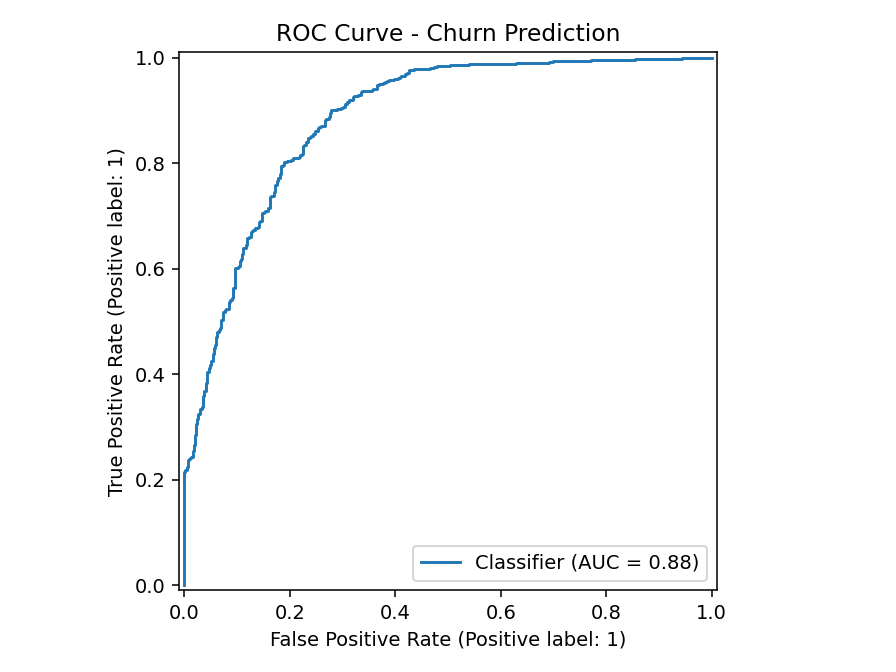
Kết quả thực nghiệm đạt ROC-AUC = 0.885 — một con số đáng tin cậy trong thực tế công nghiệp (0.5 tương đương đoán ngẫu nhiên như tung đồng xu, 1.0 là hoàn hảo tuyệt đối, và bất kỳ giá trị nào trên 0.8 thường được xem là "dùng được" trong các hệ thống production thật).
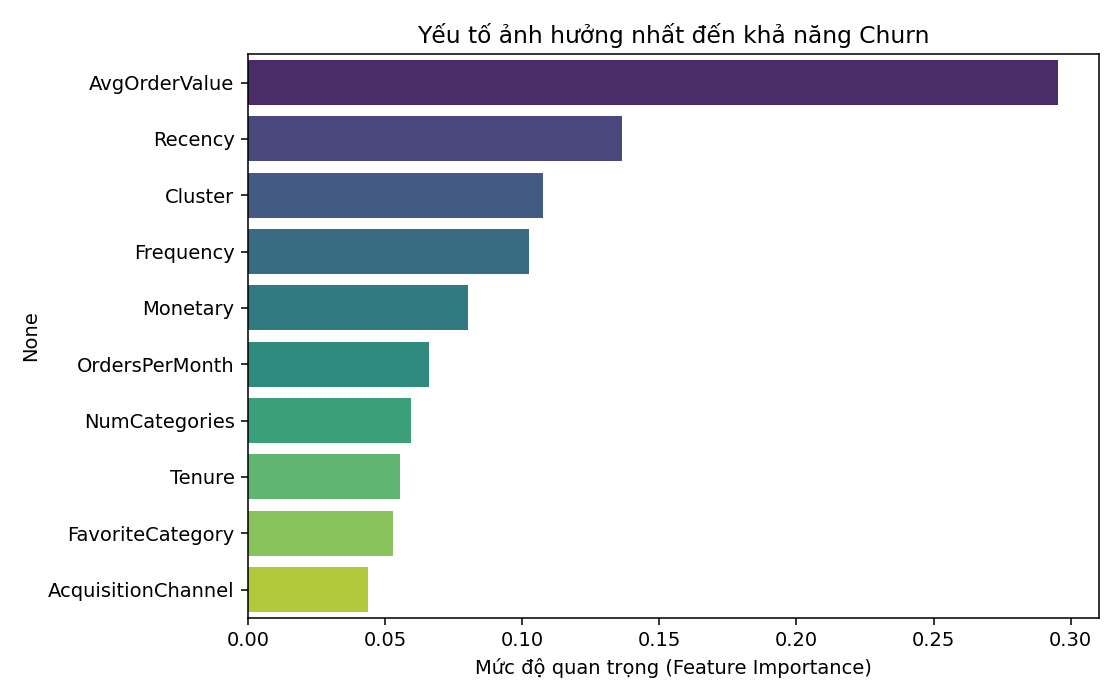
Điều thú vị nằm ở biểu đồ feature importance: mô hình tự học được rằng giá trị đơn hàng trung bình và số ngày từ lần mua cuối là hai tín hiệu mạnh nhất — hoàn toàn khớp với trực giác kinh doanh, dù không ai lập trình sẵn quy tắc này. Đây chính xác là lý do Machine Learning hữu ích: nó không cần ai dạy "nếu Recency > 90 ngày thì cảnh báo" — nó tự tìm ra ngưỡng và mối quan hệ phức tạp hơn nhiều những gì con người có thể viết thành quy tắc if-else.
Phần 5 — Dự đoán giá trị vòng đời khách hàng (CLV)
Biết ai sắp rời bỏ mới chỉ là một nửa câu chuyện. Nửa còn lại, quan trọng không kém: người đó đáng giá bao nhiêu? Một khách hàng rủi ro cao nhưng chỉ từng chi vài trăm nghìn không đáng để gọi điện cá nhân hóa tốn kém — trong khi một khách hàng rủi ro tương tự nhưng từng chi hàng chục triệu lại là ưu tiên số một.
Đây là bài toán CLV — Customer Lifetime Value, và về mặt kỹ thuật, nó gần như song sinh với bài toán churn — vẫn là XGBoost, vẫn cùng bộ feature RFM, chỉ khác duy nhất một điểm: thay vì dự đoán nhãn nhị phân (0/1), giờ đây mô hình dự đoán một số thực liên tục — số tiền khách sẽ chi trong 6 tháng tới.
Khác biệt duy nhất so với churn modelreg = XGBRegressor(...) # thay vì XGBClassifier y_train = FutureCLV # số tiền, không phải nhãn 0/1
Sự thay đổi kéo theo một hệ quả toán học: hàm mất mát chuyển từ Log Loss sang Squared Error — đo khoảng cách giữa giá trị dự đoán và giá trị thật theo đơn vị bình phương của tiền tệ:
L = (y - ŷ)²
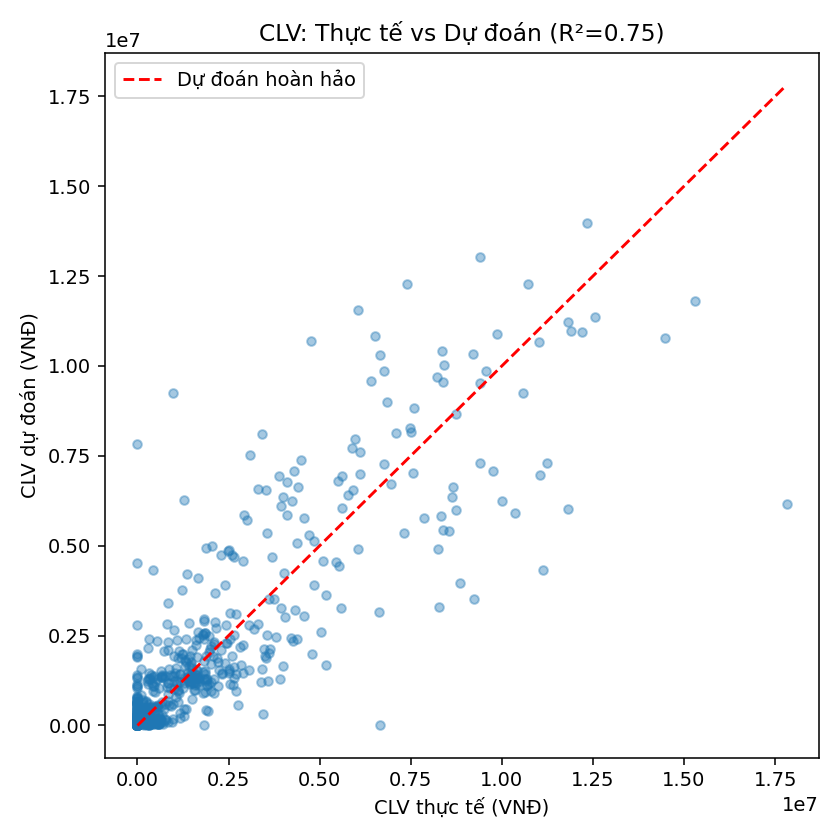
Với chỉ số R² = 0.749, mô hình giải thích được khoảng 75% biến động trong hành vi chi tiêu tương lai của khách hàng — một kết quả tốt cho bài toán vốn dĩ có nhiều yếu tố ngẫu nhiên khó lường (một khách hàng bình thường có thể đột nhiên mua một món hàng lớn vì lý do hoàn toàn cá nhân, không liên quan gì đến lịch sử mua sắm trước đó).
Phần 6 — Gộp lại: ma trận ra quyết định
Đây là bước dễ bị bỏ quên nhất trong các dự án Machine Learning — và cũng chính là bước quyết định liệu dự án có tạo ra giá trị thật hay chỉ là một bài tập kỹ thuật đẹp mắt nằm im trong ổ cứng. Một mô hình, dù chính xác đến đâu, không tự động biến thành hành động. Ai đó phải quyết định: với con số dự đoán này, nên làm gì tiếp theo?
Cách tiếp cận đơn giản nhưng cực kỳ hiệu quả là xây một ma trận 2 chiều: trục ngang là rủi ro rời bỏ (thấp/trung bình/cao), trục dọc là giá trị dự đoán (thấp/cao). Bốn góc của ma trận này tương ứng với bốn chiến lược hành động hoàn toàn khác nhau.
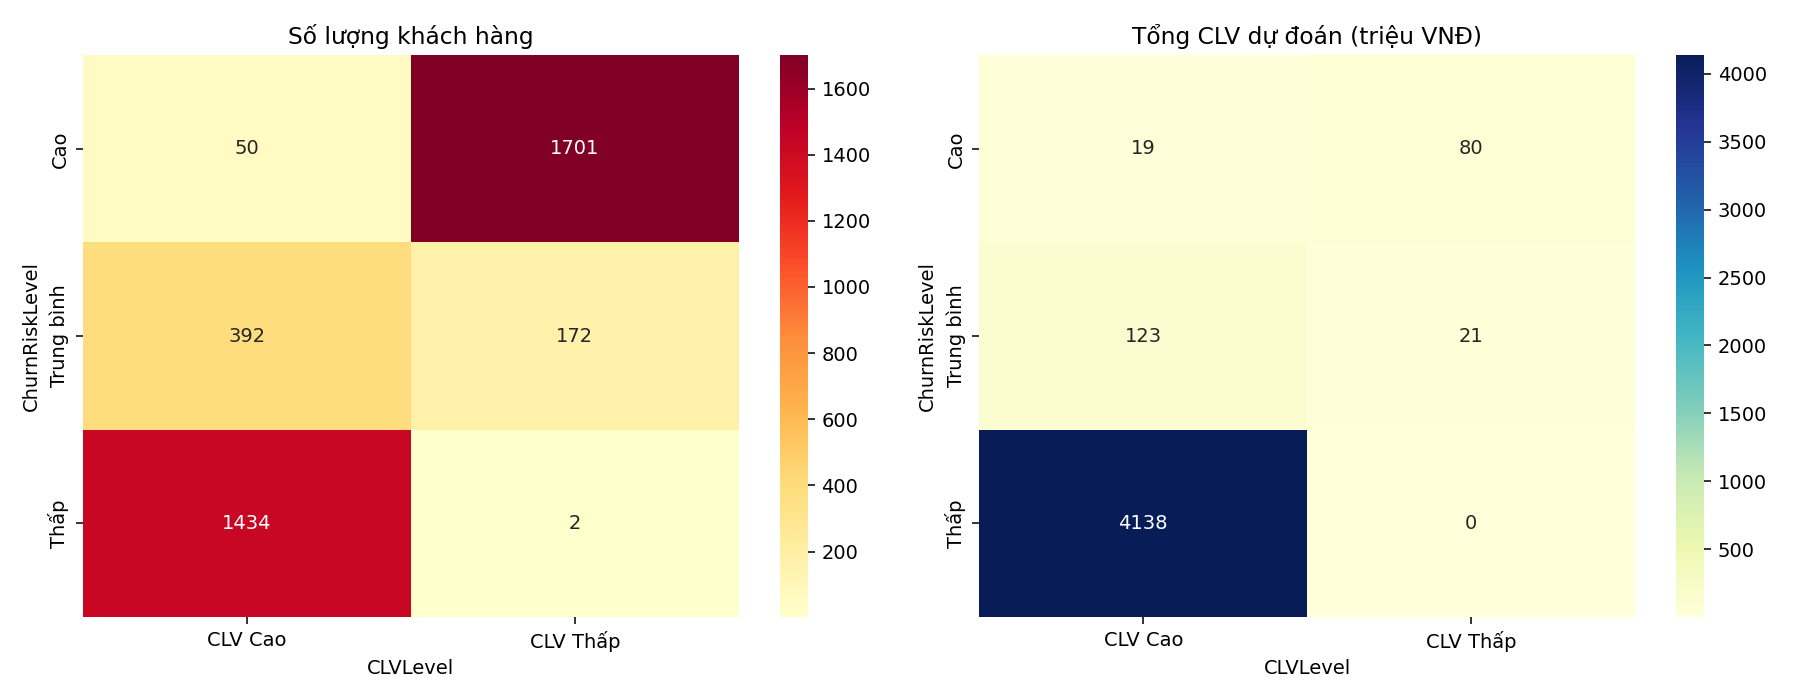
Ý nghĩa kinh doanh của ma trận này rất rõ ràng: 50 khách hàng ở góc "rủi ro cao — giá trị cao" xứng đáng nhận một cuộc gọi cá nhân hóa từ nhân viên chăm sóc khách hàng, dù tốn kém về nhân lực, vì giá trị mang lại lớn hơn nhiều chi phí bỏ ra. Ngược lại, 1.701 khách hàng rủi ro cao nhưng giá trị thấp sẽ được xử lý bằng email tự động hàng loạt — không phải vì họ kém quan trọng, mà vì chi phí can thiệp cá nhân hóa không tương xứng với lợi ích mang lại. Đây chính là bản chất của việc dùng dữ liệu để phân bổ nguồn lực có giới hạn một cách thông minh.
Phần 7 — Từ script sang sản phẩm: giao diện & quy chuẩn dữ liệu
Sáu script Python chạy tuần tự trên máy cá nhân là một chuyện. Một sản phẩm mà đội marketing có thể tự mở lên, kéo thả file, và nhìn thấy kết quả — là một câu chuyện hoàn toàn khác. Khoảng cách giữa hai thứ này chính là nơi phần lớn các dự án Data Science "chết yểu" — mô hình rất tốt trong notebook, nhưng không ai ngoài người viết code có thể sử dụng nó.
Bước đầu tiên để thu hẹp khoảng cách đó không phải là mô hình phức tạp hơn — mà là một thứ tưởng chừng nhàm chán: quy chuẩn dữ liệu đầu vào (data schema). Đây là lý do phần lớn dự án Machine Learning thất bại khi đưa vào thực tế: dữ liệu đến từ người dùng thật, dưới đủ mọi định dạng lộn xộn — ngày tháng viết kiểu 12/06/2025 lẫn với June 12, giá trị đơn hàng âm do đơn bị hủy, mã khách hàng để trống.
| Cột | Bắt buộc | Kiểu dữ liệu | Lý do |
|---|---|---|---|
| CustomerID | Có | text, không rỗng | Khóa để tính RFM theo từng khách |
| OrderDate | Có | YYYY-MM-DD | Định dạng tự do khiến code xử lý ngày lỗi ngẫu nhiên |
| OrderValue | Có | số dương | Giá trị âm/0 là dữ liệu rác |
Nguyên tắc thiết kế quan trọng nhất ở bước này: validate càng sớm càng tốt — ngay tại thời điểm người dùng tải file lên, trước khi dữ liệu bẩn có cơ hội chạm vào database hay mô hình. Nếu để lỗi lọt đến tận bước huấn luyện mô hình, việc truy tìm nguyên nhân gốc rễ sẽ khó khăn gấp nhiều lần so với việc chặn nó lại ngay từ cửa vào.
Validate ở giao diện người dùng (frontend) chỉ mang tính trải nghiệm — không bao giờ được tin tưởng hoàn toàn, vì người dùng có kỹ thuật hoàn toàn có thể bỏ qua nó. Khi xây dựng backend thật, dữ liệu phải được kiểm tra lại một lần nữa ở phía server. Đây là nguyên tắc kinh điển trong bảo mật phần mềm: never trust the client.
Phần 8 — Kiến trúc khi triển khai thật
Một câu hỏi tự nhiên xuất hiện ở giai đoạn này: vậy khi thật sự đưa hệ thống này vào vận hành cho hàng chục nghìn khách hàng, hàng chục nhân viên marketing cùng sử dụng, kiến trúc sẽ trông như thế nào? Câu trả lời đòi hỏi tách hệ thống thành nhiều lớp độc lập — mỗi lớp có thể phát triển, mở rộng, và sửa lỗi mà không ảnh hưởng đến các lớp còn lại.
Một quyết định thiết kế then chốt, dễ bị bỏ qua bởi người mới: mô hình không chạy dự đoán theo thời gian thực mỗi khi có người mở dashboard lên xem. Với hàng chục nghìn khách hàng, việc chạy lại toàn bộ pipeline RFM → Segmentation → Churn → CLV mỗi lần load trang sẽ mất hàng chục giây đến vài phút — trải nghiệm không thể chấp nhận được. Thay vào đó, kết quả được tính toán trước theo lịch (batch), thường vào ban đêm khi hệ thống ít tải, rồi lưu sẵn vào database. Khi người dùng mở dashboard, họ chỉ đang đọc một con số đã có sẵn — nhanh như đọc bất kỳ trang web thông thường nào.
| Lớp | Công nghệ đề xuất | Vai trò |
|---|---|---|
| Frontend | Next.js / React | Giao diện người dùng, không xử lý logic nghiệp vụ |
| Backend API | FastAPI (Python) | Cầu nối, xác thực request, trả dữ liệu JSON |
| Database | PostgreSQL | Lưu dữ liệu khách hàng và kết quả mô hình đã tính sẵn |
| Model serving | BentoML / FastAPI riêng | Chạy mô hình, quản lý version, scale độc lập |
| Pipeline tự động | Apache Airflow | Lên lịch tính lại mô hình định kỳ (thường mỗi đêm) |
Phần 9 — Thử với dữ liệu CRM thật
Lý thuyết là một chuyện — nhưng điều khiến một dự án trở nên đáng tin cậy là việc nó sống sót được khi va chạm với dữ liệu thật, vốn luôn lộn xộn hơn dữ liệu mô phỏng rất nhiều. Khi áp dụng cách tiếp cận này lên một bộ dữ liệu CRM thực tế — bao gồm bảng khách hàng (Account) và bảng đơn hàng (Saleorder) — một số khác biệt thú vị lộ ra ngay lập tức so với dữ liệu giả lập sạch sẽ ban đầu.
Dữ liệu thật có những đặc điểm mà dữ liệu tự tạo hiếm khi mô phỏng đủ chân thực: số điện thoại được nhập theo ba, bốn kiểu định dạng khác nhau bởi các nhân viên khác nhau (có khoảng trắng, có dấu chấm cuối, viết liền); một khách hàng có thể mang nhiều nhãn phân loại cùng lúc; phần lớn các trường như email, mã số thuế, địa chỉ chi tiết đều để trống vì không phải nghiệp vụ nào cũng thu thập đầy đủ thông tin. Đây chính là lý do bước quy chuẩn hóa dữ liệu ở Phần 7 không phải là một bước "cho có" — nó là bước sống còn khi làm việc với dữ liệu vận hành thật.
Khi mở rộng một tập dữ liệu mẫu để mô phỏng quy mô lớn hơn (ví dụ nhân dữ liệu thật lên hàng chục nghìn dòng để kiểm thử hệ thống), điều quan trọng không phải là tạo số liệu ngẫu nhiên, mà là giữ nguyên phân phối thống kê gốc — đúng tỷ lệ nguồn khách hàng, đúng mối quan hệ giữa nhân viên phụ trách và chi nhánh, đúng tỷ lệ dữ liệu bị thiếu. Dữ liệu demo không tôn trọng phân phối gốc sẽ khiến mọi mô hình huấn luyện trên đó trở nên vô nghĩa khi áp dụng lại vào dữ liệu thật.
Điều này dẫn đến một nguyên lý bao trùm toàn bộ hành trình được kể trong bài viết: chất lượng của một hệ thống Machine Learning không được quyết định bởi thuật toán, mà được quyết định bởi mức độ tôn trọng thực tế lộn xộn của dữ liệu đầu vào. Một XGBoost với ROC-AUC 0.885 chạy trên dữ liệu sạch có thể trở nên vô dụng nếu pipeline phía trước không xử lý đúng dữ liệu bẩn từ đời thực.
Phần 10 — Những gì rút ra được
Nhìn lại toàn bộ hành trình — từ ba con số RFM đơn giản, qua K-Means để hiểu khách hàng là ai, qua XGBoost để dự đoán tương lai của họ, đến một giao diện web thật và một kiến trúc sẵn sàng cho production — có vài bài học đáng để mang theo cho bất kỳ ai muốn tự đi lại con đường này:
- ·Mô hình đơn giản, đặt đúng chỗ, có giá trị hơn mô hình phức tạp bị bỏ quên. RFM chỉ là ba phép tính cộng trừ, nhưng lại là nền tảng cho mọi thứ phía sau.
- ·Data leakage là cái bẫy âm thầm nguy hiểm nhất. Một mô hình "quá tốt để là thật" trong lúc test thường đúng là như vậy — hãy nghi ngờ trước khi ăn mừng.
- ·Một mô hình không tự động là một sản phẩm. Khoảng cách từ notebook đến thứ người dùng thật có thể chạm vào đòi hỏi tư duy hoàn toàn khác — giao diện, quy chuẩn dữ liệu, kiến trúc hệ thống.
- ·Đừng xây kiến trúc phức tạp trước khi cần nó. Một bản demo Streamlit chạy trong một buổi chiều thường có giá trị học tập lớn hơn một kiến trúc microservices dang dở sau ba tháng.
Nếu có một câu để tóm gọn toàn bộ bài viết này, có lẽ đó là: Machine Learning không phải là phép màu biến dữ liệu thành tiền bạc — nó là một chuỗi các quyết định kỹ thuật nhỏ, mỗi quyết định đều có thể sai, và giá trị thật sự nằm ở việc hiểu vì sao mỗi bước lại được thực hiện như vậy, chứ không chỉ đơn thuần copy-paste code chạy được.
Dữ liệu tốt nhất bạn có không phải là dữ liệu bạn ước mình có, mà là dữ liệu lộn xộn bạn đang thật sự nắm trong tay — câu hỏi chỉ là bạn xử lý nó tôn trọng đến mức nào.
Bài viết được biên soạn như một case study minh hoạ cho quá trình xây dựng hệ thống Customer Intelligence từ đầu đến cuối — từ RFM, K-Means, XGBoost cho churn và CLV, đến kiến trúc production thật. Tám biểu đồ trong bài là kết quả thực nghiệm thật, không phải hình vẽ minh hoạ.
Sơ đồ pipeline và minh hoạ cụm K-Means dùng SVG/CSS dựng trực tiếp trên trang; 8 hình còn lại (Elbow/Silhouette, PCA, RFM boxplot, Confusion Matrix, ROC Curve, Feature importance, CLV scatter, ma trận quyết định) là ảnh chụp thật từ kết quả chạy mô hình.